Prever o Futuro Não É Opcional
A tomada de decisão suportada por dados deixou de ser um fator diferenciador entre empresas e passou a ser uma necessidade. Num mercado cada vez mais competitivo, a capacidade de antecipar comportamentos, tendências e eventos futuros pode ser o fator-chave que dita o sucesso de uma estratégia.
É evidente que devemos aprender com os erros de experiências passadas, evitando repeti-los. Além disso, prever os resultados de certas decisões antes de as tomar, apenas com base em dados históricos, representa uma vantagem significativa.
No entanto, nós, humanos, temos alguma dificuldade em aprender com os erros do passado. Temos ainda maior dificuldade em prever o futuro com algum rigor, com base em informações passadas.
Isto deve-se, muitas vezes, às inúmeras possibilidades e à complexidade das variáveis, bem como à forma como se relacionam entre si.
É precisamente neste ponto que entram os modelos preditivos de Machine Learning.
O Que É um Modelo Preditivo?
Um modelo preditivo, tal como o nome sugere, é um modelo matemático que tem como objetivo prever um resultado (variável target) com base nos dados disponíveis (variáveis de entrada).
Para tal, podem ser utilizados modelos supervisionados, em que os modelos aprendem com dados rotulados, e modelos não supervisionados, em que os modelos analisam dados não rotulados.
Neste último caso, os modelos procuram encontrar relações entre as variáveis e agrupá-las de forma coerente.
Se quiser saber mais sobre modelos supervisionados e não supervisionados, consulte este artigo sobre Machine Learning.
Atualmente, estes modelos são utilizados em diversas indústrias e para múltiplos fins. Por exemplo, permitem apoiar a previsão de vendas, a deteção de fraudes e o diagnóstico de doenças, entre muitas outras aplicações.
Tipos de Modelos Preditivos
Na maioria das vezes, quando se fala em modelos preditivos, pensa-se em algoritmos de regressão ou de classificação.
Apesar de estes serem os mais conhecidos, existem outros modelos que também se enquadram no contexto de antecipação de resultados.
Neste artigo, vamos abordar três dos tipos de modelos preditivos mais conhecidos. Para isso, utilizaremos exemplos práticos da sua aplicação e gráficos explicativos.
Regressão – Previsão de Valores Contínuos
Os modelos de regressão são aplicados quando a variável a prever (variável dependente) é numérica e contínua. Além disso, esta variável apresenta uma relação com as variáveis de entrada (variáveis independentes).
Quando essa relação é linear, estamos perante uma regressão linear. Por outro lado, quando a relação não é linear, como acontece numa relação quadrática, estamos perante uma regressão polinomial.
Estes são dois dos tipos de regressão mais utilizados.
Exemplo Prático de Regressão
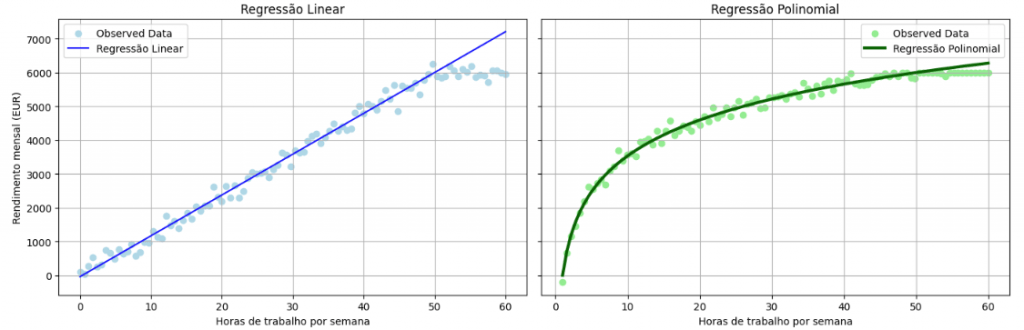
Para ilustrar estes dois tipos de regressão, observe os gráficos seguintes.
No gráfico da esquerda, temos uma regressão linear. Neste caso, existe uma relação constante entre a variável de entrada (horas de trabalho semanais) e a variável dependente (rendimento mensal).
Por outro lado, o gráfico da direita representa uma regressão polinomial. Neste exemplo, o rendimento aumenta com o número de horas trabalhadas até determinado ponto. No entanto, tende a estabilizar após as 40 horas de trabalho semanal.
Cassificação – Previsão de Categorias Discretas
Os modelos de classificação são utilizados quando a variável a prever assume valores categóricos. Por exemplo, estes valores podem ser “sim” ou “não”, “compra” ou “não compra”.
Assim, o objetivo destes modelos é prever a que classe pertence uma nova observação, com base nos padrões identificados nas observações anteriores.
A classificação pode ser binária, quando o modelo prevê entre dois possíveis resultados. Por outro lado, é multiclasse quando existem três ou mais resultados possíveis.
Exemplo Prático de Classificação
Um caso clássico em que se aplicam modelos de classificação é a deteção de spam em e-mails.
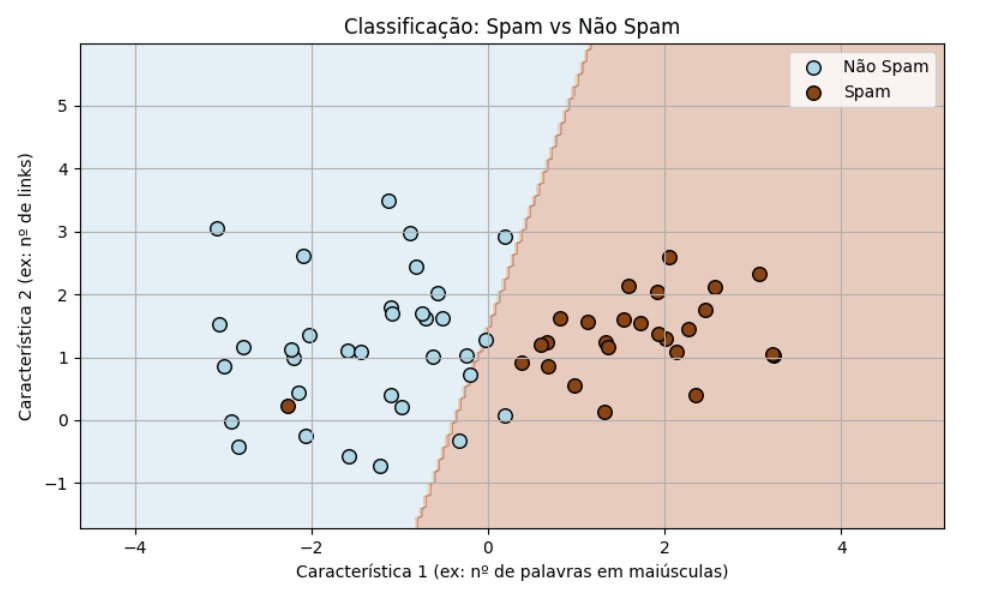
Neste exemplo, o modelo utiliza dados rotulados de e-mails durante o treino. Para isso, considera as variáveis “número de palavras em maiúsculas” e “número de links”.
Depois do treino, o modelo “desenha” uma fronteira de decisão, ilustrada no gráfico abaixo. Desta forma, separa as observações consideradas “spam” das consideradas “não spam”.
Neste caso, ao receber um novo e-mail, o modelo procura prever se se trata de spam ou não spam.
Para isso, analisa as duas variáveis e, consequentemente, a posição do e-mail no espaço de decisão representado abaixo.
Clustering – Agrupar com Base nas Semelhanças
O clustering permite segmentar observações em grupos (clusters), com base em características comuns.
Neste processo, o modelo forma grupos de modo que as observações dentro do mesmo cluster estejam mais próximas entre si do que das observações de outros clusters.
Além disso, este agrupamento é especialmente útil porque permite descobrir padrões ou relações desconhecidas e pouco evidentes nos dados.
Exemplo Prático de Clustering
Uma loja online, com acesso a dados sobre os seus clientes, aplicou um modelo de clustering com o objetivo de descobrir padrões ou perfis de comportamento.
Desta forma, obteve o seguinte resultado:
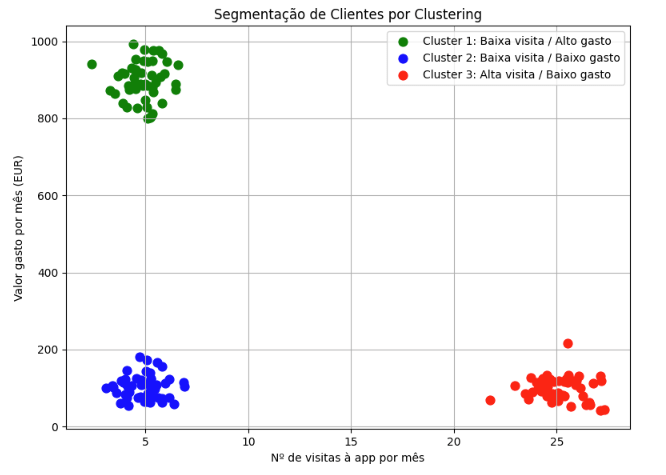
A partir do gráfico apresentado, podemos concluir que o modelo agrupou os clientes em três grupos diferentes:
- Baixa frequência de visitas e baixo gasto;
- Alta frequência de visitas e baixo gasto;
- Baixa frequência de visitas e alto gasto.
Assim, esta segmentação de clientes pode ser utilizada para desenvolver campanhas de marketing personalizadas para cada grupo.
Consequentemente, permite aumentar a eficácia da comunicação e o retorno destas ações.
O Poder Está nos Dados
Seja através da previsão de valores numéricos, da classificação em diferentes categorias ou do agrupamento de observações com características semelhantes, os modelos preditivos são ferramentas poderosas.
Por isso, a sua utilização tem vindo a aumentar entre as empresas que pretendem tirar maior partido dos dados que possuem.
O sucesso de qualquer modelo preditivo depende de vários fatores. No entanto, o principal é a qualidade dos dados.
Por muito bem construído que um modelo esteja, o seu desempenho nunca será extraordinário se os dados forem incompletos, desatualizados ou mal estruturados.
Isto aplica-se tanto aos dados de treino e de teste como aos próprios dados sobre os quais o modelo irá realizar previsões.
Na B2F, ajudamos as organizações a estruturar os seus dados, a integrar múltiplas fontes de informação e a manter bases de dados atualizadas e fiáveis.
Desta forma, garantimos a base necessária para o sucesso dos seus projetos de Machine Learning.
Antecipe o Futuro do Seu Negócio com a B2F
A sua empresa dispõe de grandes volumes de dados, mas ainda tem dificuldade em antecipar tendências, prever resultados ou identificar oportunidades de crescimento?
Com a experiência da B2F em Machine Learning, análise preditiva e Business Intelligence, pode transformar os seus dados em informação estratégica e apoiar decisões empresariais mais informadas.