In the universe of Business Intelligence moderno, lidar com grandes volumes de dados de forma eficiente é um desafio constante. Neste contexto, o Microsoft Fabric surge como uma plataforma unificada que simplifica a arquitetura de dados.
Além disso, a sua integração com o Apache Spark is at the heart of its large-scale data processing capability.
Neste artigo, vamos explorar como esta poderosa combinação funciona. Para isso, começaremos por compreender o papel do Spark no processamento distribuído e as suas principais vantagens.
Em seguida, mostraremos como configurar e melhorar a otimização Spark no Microsoft Fabric, através de diferentes configurações de clusters.
1. Overview of Microsoft Fabric
The Microsoft Fabric consolida diferentes funcionalidades numa única plataforma, facilitando a gestão integrada da informação.
Entre estas funcionalidades, destacam-se Data Warehousing, Data Engineering, processamento em tempo real, Data Science and Machine Learning.
Desta forma, as organizações conseguem gerir diferentes processos analíticos num ambiente unificado.
2. How Does Spark Work?
The Apache Spark é um mecanismo de processamento distribuído que funciona através de uma arquitetura master-worker, com paralelismo inerente.
Assim, permite processar grandes volumes de dados através de múltiplas máquinas de forma coordenada.
2.1. Parallelism Architecture in Spark
Spark operates on a hierarchical architecture composed of two main types of nodes: the master node (also referred to as driver) and the worker nodes, que executam os executors.
Esta distribuição permite ao Spark dividir tarefas complexas em operações mais pequenas. Desta forma, diferentes componentes conseguem executar essas operações em paralelo.
Driver Node
The driver node atua como o coordenador central do cluster.
Neste sentido, assume as seguintes responsabilidades:
- Analisar, distribuir e agendar tarefas entre os executors.
- Maintaining the SparkContext, que representa a ligação ao cluster Spark.
- Monitorizar o progresso da execução e garantir tolerância a falhas.
Worker Nodes e Executors
Por outro lado, os worker nodes contain the executors, que são processos responsáveis pela execução real das tarefas.
Cada executor tem duas responsabilidades principais:
- Executar o código atribuído pelo driver/worker node.
- Reportar o progresso dos cálculos de volta ao driver node.
2.2. How Parallelism Works
O Spark alcança o paralelismo através da divisão dos dados em partitions, que distribui pelos diferentes nós do cluster.
Desta forma, diferentes threads processam cada partição de forma independente, permitindo executar operações simultâneas.
Por exemplo, se um dataset estiver dividido em múltiplas partições de 128 MB, diferentes executors podem processá-las em paralelo.
Consequentemente, esta distribuição permite maximizar a utilização dos recursos computacionais.
Além disso, o Spark cria um DAG (Directed Acyclic Graph) para programar tarefas e orquestrar os nós worker no cluster.
Este mecanismo permite otimizar a sequência de operações. Por outro lado, facilita a recuperação em caso de falhas, replicando apenas as operações necessárias nos dados de um estado anterior.
3. Spark Configurations in Microsoft Fabric
A configuração dos clusters é uma etapa importante na otimização Spark no Microsoft Fabric.
Por isso, é fundamental considerar os requisitos de acesso, o dimensionamento dos recursos e as características dos processos.
3.1. Prerequisites
Antes de iniciar a configuração, é necessário garantir:
- Acesso ao portal do Microsoft Fabric com as permissões necessárias (admin, contributor or member).
- SKU de Fabric previamente contratado ou Fabric Trial ativo.
3.2. Configuration Steps
Pre-warmed Cluster Configuration
The Microsoft Fabric oferece Starter Pools that use clusters pre-warmed, executados em máquinas virtuais da Microsoft.
Desta forma, conseguem reduzir significativamente os tempos de início.
Estes clusters estão ativos e preparados para utilização, proporcionando a inicialização de sessões Spark tipicamente entre 5 e 10 segundos.
Além disso, não exigem configuração manual.
Os Starter Pools utilizam nós de tamanho médio, que escalam dinamicamente de acordo com as necessidades dos trabalhos Spark.
Assim, quando não existem dependências de bibliotecas personalizadas ou propriedades Spark customizadas, as sessões podem iniciar quase instantaneamente.
Isto acontece porque o cluster já se encontra em execução e não necessita de tempo adicional de provisionamento.
No entanto, existem cenários em que o tempo de início pode ser superior:
- Bibliotecas personalizadas: Podem acrescentar entre 30 segundos e 5 minutos para personalização da sessão.
- Alta utilização regional: Quando os Starter Pools estão saturados, a criação de novos clusters pode demorar entre 2 e 5 minutos.
- Opções de rede: Private Links ou Managed VNets podem desativar os Starter Pools, obrigando à criação de clusters on-demand.
High Concurrency Mode Activation
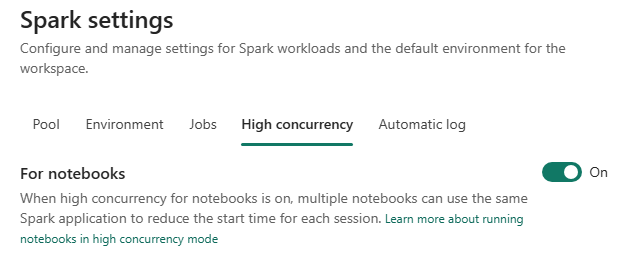
It is recommended to enable the High Concurrency Mode para permitir que múltiplos notebooks partilhem a mesma sessão Spark.
Desta forma, é possível otimizar a utilização de recursos e reduzir significativamente os tempos de início.
Além disso, os pools personalizados com High Concurrency proporcionam uma experiência de início de sessão mais rápida, comparativamente às sessões Spark standard.
To enable High Concurrency Mode:
- Access the Workspace Settings.
- Navigate to Data Engineering/Science > Spark Settings > High Concurrency.
- Enable the option For notebooks.
EEspecificações Recomendadas para Pools
Para demonstrar as configurações ideais, consideremos um exemplo com o SKU F64.
Base Capacity:
- F64 = 64 Capacity Units = 128 Spark VCores.
- Com um burst factor 3x, é possível atingir um máximo de 384 Spark VCores.
Neste caso, o burst factor multiplica a capacidade de processamento disponível, permitindo aumentar o desempenho.
| Parameter | Valor Recomendado | Explanation |
|---|---|---|
| Node Family | Memory Optimized | Suitable for data processing workloads |
| Node Size | Medium (8 VCores) | Balance between performance and concurrency |
| Autoscale | Enabled (min: 2, max: 48) | 48 nodes × 8 VCores = 384 VCores (maximum burst) |
| Dynamic Allocation | Enabled | Allows automatic adjustment of executors based on demand |
Dynamic Allocation Configuration:
- Min Executors: 2 (baseline para disponibilidade imediata).
- Max Executors: 46 (reservando 2 nós para driver e overhead).
- Initial Executors: 4 (equilíbrio entre tempo de arranque e utilização de recursos).
Scaling Based on SKU:
For different SKUs, the maximum configurations vary:
| SKU | Capacity Units | Max Spark VCores | Recommended Node Size | Max Nodes |
|---|---|---|---|---|
| F2 | 2 | 12 | Small | 3 |
| F8 | 8 | 48 | Medium | 6 |
| F16 | 16 | 96 | Medium | 12 |
| F64 | 64 | 384 | Medium/Large | 48/24 |
| F128 | 128 | 768 | Large | 48 |
Dynamic Allocation Configuration:
- Min Executors: 2 (baseline para disponibilidade imediata).
- Max Executors: 46 (reservando 2 nós para driver e overhead).
- Initial Executors: 4 (equilíbrio entre tempo de arranque e utilização de recursos).
Scaling Based on SKU
Para diferentes SKUs, as configurações máximas variam.
Por isso, é importante avaliar os recursos disponíveis antes de definir o número e o tamanho dos nós.
| SKU | Capacity Units | Max Spark VCores | Recommended Node Size | Max Nodes |
|---|---|---|---|---|
| F2 | 2 | 12 | Small | 3 |
| F8 | 8 | 48 | Medium | 6 |
| F16 | 16 | 96 | Medium | 12 |
| F64 | 64 | 384 | Medium/Large | 48/24 |
| F128 | 128 | 768 | Large | 48 |
Configuration Through the Portal
Depois de definir os requisitos do cluster, é possível avançar para a configuração no portal do Microsoft Fabric.
In the Microsoft Fabric portal:
- Go to the section Engenharia de Dados > Spark Settings.
- Select New Pool para criar um cluster personalizado.
- Set the Node Family and Node Size, conforme os requisitos.
- Configurar o Autoscale, com número mínimo de nós igual a 1 (o Fabric garante disponibilidade restaurável mesmo com um único nó).
- Enable Dynamic Executor Allocation para otimizar automaticamente os recursos.
Integration with Data Sources:
- Utilizar conectores nativos para estabelecer ligações a Data Lakes or Data Warehouses.
- Além disso, verificar se as credenciais e configurações de segurança estão corretamente definidas.
Notebook and Task Configuration:
- Configurar notebooks (Python ou Scala) para desenvolver scripts de transformação.
- Posteriormente, agendar tarefas batch ou configurar processos streaming, conforme os requisitos.
Custom pools have a autopause padrão de 2 minutos.
Após esse período de inatividade, as sessões expiram e os clusters deixam de ter recursos alocados. Desta forma, a plataforma cobra apenas pelo tempo de utilização ativa.
No entanto, as parametrizações ideais do cluster podem variar consoante os processos que serão executados.
Por isso, é fundamental realizar uma avaliação acompanhada de testes para cada caso.
4. Best Practices and Technical Considerations
A otimização Spark no Microsoft Fabric exige uma avaliação adequada dos recursos disponíveis e das características de cada processo.
Neste sentido, é importante considerar o dimensionamento, a automatização, a monitorização e a segurança.
Sizing and Optimization
É fundamental dimensionar corretamente o cluster.
Para isso, considere os seguintes fatores:
Burst Factor: Determine a capacidade de escalabilidade instantânea necessária para lidar com picos de processamento.
Neste caso, a lógica deve incluir a multiplicação do número de VCores utilizados na seleção. Assim, é possível atingir o burst factor pretendido.
Por exemplo, para um SKU F64, com 128 VCores base, configure o pool para atingir até 384 VCores.
Para isso, ajuste o número e o tamanho dos nós, como no exemplo: Medium nodes (8 VCores cada) × 48 nós = 384 VCores.
Número de Cores e Memória: Para o driver node, selecione um número adequado de cores e memória.
Isto é importante porque este nó coordena o processamento e deve suportar as tarefas de gestão do cluster.
Por outro lado, nos worker nodes, a escolha deve considerar a multiplicação dos recursos necessários para o processamento paralelo, nomeadamente núcleos e memória.
Além disso, avalie a possibilidade de escalar estes nós para ajustar o desempenho conforme a carga.
Automation and Scheduling
Automatize processos recorrentes através de scripts e agendamentos.
Desta forma, consegue garantir maior consistência e minimizar erros.
Monitoring
Utilize as ferramentas de monitorização nativas do Microsoft Fabric para identificar possíveis problemas.
Assim, pode ajustar o desempenho do cluster em tempo real.
Security
Assegure a implementação de políticas de segurança robustas, configurando as permissões necessárias.
Além disso, utilize ligações seguras para garantir o acesso adequado aos dados.
Quais os Próximos Passos?
A B2F dispõe de uma sólida experiência no desenvolvimento de soluções em Microsoft Fabric, assim como na implementação de processos baseados em Apache Spark.
Caso necessite de apoio especializado para maximizar o desempenho e a eficiência da sua plataforma analítica, a nossa equipa está preparada para colaborar consigo.
Desta forma, podemos encontrar as soluções mais adequadas aos desafios específicos da sua organização.