Turning Data into Intelligence
Vivemos numa era em que os dados são gerados a uma velocidade nunca vista. Por isso, transformar grandes quantidades de dados em bruto em informação útil para apoiar a tomada de decisão é um dos maiores desafios das organizações atuais.
But how can data help us make informed decisions quickly and efficiently?
É precisamente neste ponto que entra o Machine Learning.
De uma forma simplista, o Machine Learning é um campo da inteligência artificial que permite aos computadores aprender a partir dos dados. Em vez de seguirem regras fixas previamente programadas, os algoritmos analisam os dados e identificam padrões. Desta forma, conseguem evoluir com base na experiência.
What can computers learn?
Com acesso a grandes volumes de dados, um algoritmo de Machine Learning pode descobrir relações entre variáveis, classificar informações, fazer previsões e até tomar decisões. Assim, esta capacidade abre portas para inúmeras aplicações em diversas áreas.
As três fases de um projeto de Machine Learning
Podemos dizer que um projeto de Machine Learning envolve três fases distintas:
- Recolha e preparação de dados: Nesta fase inicial, recolhem-se os dados necessários para resolver um determinado problema. Em seguida, procede-se ao seu tratamento, garantindo que têm qualidade suficiente para o modelo. Esta é a primeira e, talvez, a fase mais crítica para o sucesso de um modelo de Machine Learning.
- Escolha e treino do modelo: Após a preparação dos dados, seleciona-se o tipo de modelo de Machine Learning mais adequado ao problema em questão. Para isso, consideram-se os dados disponíveis e o objetivo que pretendemos alcançar. Posteriormente, utilizam-se os dados preparados para “ensinar” o modelo, permitindo-lhe identificar padrões e estabelecer relações entre variáveis.
- Avaliação e melhoria do modelo: Por fim, testa-se o desempenho do modelo com dados aos quais este não teve acesso na fase anterior, a fase de treino. Com base nos resultados destes testes, realizam-se ajustes para otimizar o modelo e garantir melhores resultados.
Este artigo é uma introdução ao vasto mundo do Machine Learning. Por isso, vamos começar por explorar os seus dois principais tipos: Supervised Learning (Supervised Learning) e Unsupervised Learning (Unsupervised Learning). Ao longo do artigo, explicamos de forma simples o significado de cada um.
Supervised Learning
O que é a Aprendizagem Supervisionada?
A Supervised Learning (Supervised Learning) é um tipo de Machine Learning em que o algoritmo aprende com dados rotulados.
Ou seja, para cada conjunto de variáveis de entrada, existe um resultado conhecido, a variável based. Assim, o principal objetivo destes modelos é aprender a relação entre os dados de entrada e a variável based, permitindo realizar previsões com precisão.
In general, supervised models fall into two main categories:
- Classificação: O objetivo é prever categorias ou classes (por exemplo, identificar se um e-mail é spam ou não).
- Regressão: The goal is to predict continuous numerical values (for example, estimating a supermarket’s monthly sales).
Exemplo Prático de Aprendizagem Supervisionada
Uma forma simples de compreender a aprendizagem supervisionada é fazer uma analogia com o processo de aprendizagem dos nomes das frutas por uma criança.
Inicialmente, ao ver uma fruta pela primeira vez, a criança não saberá identificá-la. No entanto, após observar diferentes frutas com os respetivos nomes por diversas vezes, começa a identificar corretamente cada uma delas.
Com mais prática, a criança torna-se capaz de identificar as frutas de forma quase automática. O mesmo acontece com um modelo de Machine Learning supervisionado.
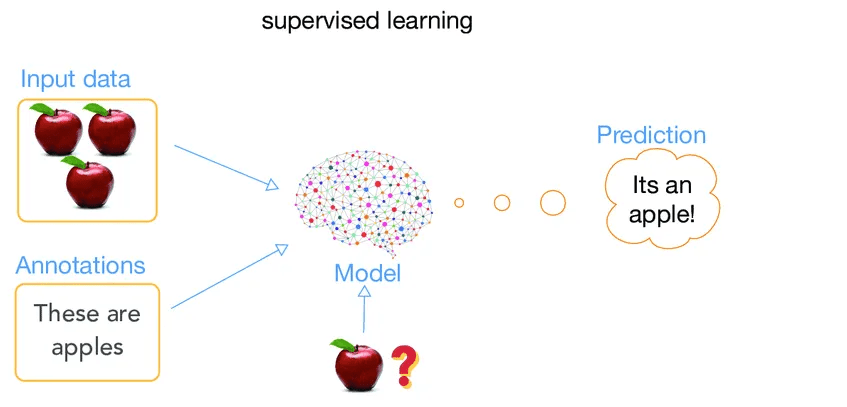
Na prática, é perfeitamente possível construir um modelo de Machine Learning para classificar imagens de frutas. Assim, podemos dividir este processo nas três fases explicadas na introdução.
Phase 1 – Data collection and preparation
Nesta fase, é necessário recolher diversas imagens de diferentes tipos de frutas.
Para garantir que o modelo aprende de forma eficaz, é importante captar imagens sob diferentes condições de iluminação e de vários ângulos. Além disso, devem considerar-se diferentes variações, como tamanho, cor e fundo.
Desta forma, uma preparação cuidadosa garante que o modelo dispõe de dados representativos e variados para treinar.
Phase 2 – Model selection and training
Nesta fase, escolhe-se um modelo de classificação, uma vez que o objetivo é identificar uma categoria (nome da fruta) com base na imagem.
O processo de treino consiste em apresentar as imagens (variáveis de entrada) ao modelo, juntamente com a respetiva classificação correta (variável de saída).
No início, o modelo não saberá reconhecer nenhuma fruta, tal como a criança. No entanto, à medida que recebe múltiplos exemplos durante o treino, começa a perceber padrões e associações.
Por exemplo, se uma fruta é amarela, tem determinado tamanho e apresenta uma ligeira curvatura, provavelmente é uma banana.
Phase 3 – Model evaluation and improvement
Depois do treino, testa-se o modelo com um novo conjunto de imagens, diferente daquele que utilizou durante a fase anterior.
Desta forma, é possível verificar se consegue fazer previsões corretas.
Se o desempenho for satisfatório, o modelo pode ser considerado concluído. Caso contrário, poderá ser necessário otimizá-lo. Para isso, podem ajustar-se os parâmetros do modelo, utilizar mais imagens ou melhorar a qualidade e diversidade dos dados.
Unsupervised Learning
O que é a Aprendizagem Não Supervisionada?
A Unsupervised Learning (Unsupervised Learning) é um tipo de Machine Learning em que o algoritmo aprende com dados não rotulados.
Ou seja, as variáveis de entrada não têm nenhum resultado conhecido associado. Assim, o objetivo destes modelos é identificar padrões e relações entre variáveis que não conseguimos reconhecer facilmente.
Ao contrário dos modelos supervisionados, o modelo não procura aprender a prever um valor conhecido. Em vez disso, tenta descobrir, de forma autónoma, como os dados se organizam.
In general, unsupervised models fall into two main categories:
- Clustering (agrupamento): O objetivo é identificar grupos ou segmentos naturais nos dados (por exemplo, agrupar clientes com comportamentos de compra semelhantes).
- Redução de dimensionalidade: O objetivo é simplificar os dados, procurando encontrar relações entre variáveis e mantendo as características mais relevantes (por exemplo, eliminar uma variável que pode ser explicada por outras, evitando redundância de informação).
Exemplo Prático de Aprendizagem Não Supervisionada
Para tornar mais fácil de compreender o conceito de Unsupervised Learning, vamos retomar a analogia da criança e das peças de fruta.
Neste caso, vamos imaginar que a criança ainda não sabe o nome de nenhuma fruta. Em seguida, recebe um saco com maçãs, laranjas e bananas e três cestos vazios.
Depois, pedem-lhe que distribua as frutas pelos três cestos, agrupando as do mesmo tipo.
É expectável que a criança, mesmo sem saber os nomes das frutas, consiga colocar as maçãs num cesto, as laranjas noutro e as bananas no último cesto.
Para isso, utiliza as semelhanças visuais entre as frutas, como a cor, o tamanho e a forma.
O modelo de Machine Learning atua de forma semelhante. Assim, organiza os dados com base em padrões, sem precisar de instruções explícitas.
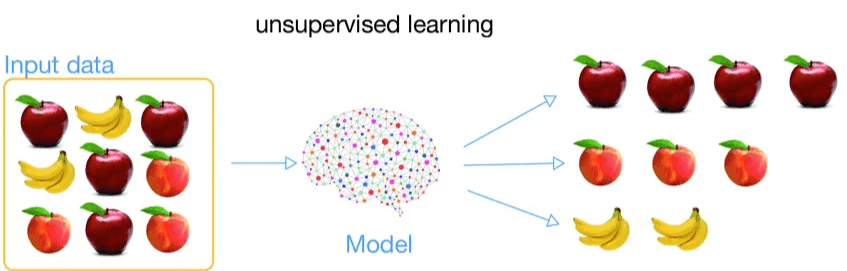
Na prática, também é possível construir um modelo de Machine Learning para agrupar imagens de frutas com base nas suas semelhanças. Tal como no exemplo anterior, este processo pode dividir-se nas três fases explicadas na introdução.
Phase 1 – Data collection and preparation
Tal como na aprendizagem supervisionada, é necessário recolher um conjunto diversificado de imagens de frutas.
No entanto, neste caso, não é necessário rotular as imagens com os nomes das frutas.
Por isso, o foco está em garantir a diversidade dos dados, incluindo variações de cor, tamanho, formato e iluminação. Desta forma, o modelo terá boas bases para identificar padrões.
Phase 2 – Model selection and training
Nesta fase, escolhe-se um modelo de clustering (agrupamento), que analisa as imagens e as agrupa com base em características comuns.
Durante o treino, o modelo não recebe nenhuma indicação sobre a forma como deve agrupar as frutas. Em vez disso, observa as semelhanças e diferenças entre os dados.
Por exemplo, é possível que o modelo agrupe todas as frutas amarelas de forma alongada num único grupo. Neste caso, esse grupo provavelmente corresponde às bananas, mesmo sem o modelo saber o nome dessa fruta.
Phase 3 – Model evaluation and improvement
Após o agrupamento das imagens, podemos avaliar o modelo, verificando se os grupos formados fazem sentido do nosso ponto de vista.
Por exemplo, podemos verificar se todas as bananas pertencem ao mesmo grupo.
Caso o agrupamento não seja satisfatório, podemos realizar melhorias. Para isso, é possível alterar o número de grupos esperados, adicionar mais imagens ou utilizar outro algoritmo mais adequado à natureza dos dados.
O Mais Importante… Não É o Algoritmo
Neste artigo, explorámos os fundamentos de Machine Learning: Supervised Learning and Unsupervised Learning.
Enquanto a Aprendizagem Supervisionada tem como base dados rotulados e objetivos bem definidos, como classificação ou previsão de valores, a Aprendizagem Não Supervisionada procura padrões “escondidos” nos dados.
Desta forma, revela relações que nem sempre são evidentes.
Em ambos os casos, o objetivo é transformar dados em informação útil, um desafio cada vez mais presente nas organizações modernas.
No entanto, o sucesso de qualquer projeto nesta área não depende apenas do algoritmo utilizado, mas, acima de tudo, da qualidade dos dados.
Transforme os Dados da Sua Empresa em Decisões Mais Inteligentes
A sua empresa dispõe de grandes volumes de dados, mas ainda tem dificuldade em transformá-los em informação útil para o negócio?
Com as soluções de Machine Learning, Artificial Intelligence and Business Intelligence da B2F, pode explorar padrões, desenvolver modelos preditivos e identificar oportunidades para melhorar a tomada de decisão.